一、测试环境与目的
测试机为 Windows 11 家庭中文版,AMD64 架构,显卡 NVIDIA GeForce GTX 1650(4GB 显存,无 Tensor Core),内存 16GB,NVIDIA 驱动 610.74,支持 CUDA 13.3。测试目的是验证本地模型能力或智力,在内网环境下如何调用本地模型解决问题,能否能支撑 aardio autos 、 workbuddy 等等这类 agent 工具工作。
二、选型
选择工具:llama.cpp。因为其开源,且占用内存较低。选择模型:先说主观原因。由于工作关系,经常用AI辅助完成项目策划工作,众多模型中,主观觉得Qwen系列的智商较高。再说客观原因,由于电脑硬件限制,4GB 显存已经把可选范围压得很窄。Qwen3-30B-A3B 虽然激活参数只有 3B,但 Q4_K_M 文件体积达 18.63GB,超出整机内存(电脑 16G内存,但运行起win11后,只剩下12G左右),直接排除。Gemma-4-26B-A4B 约 15GB,Windows 自身还要占 3-4GB,有 OOM 风险。gpt-oss-20B 约 12.2GB 理论上能装,但要手动调专家卸载参数,内存余量所剩无几。最终选定 Qwen3-8B-Q4_K_M,文件 4.68GB。这是本机在 Dense 架构下能兼顾速度与能力的上限。同体积的 Gemma-4-E2B(2.6-3GB)作为备选,胜在支持图片与音频输入。
三、部署过程
整个过程交给 agent,如workbuddy、千问的工作模式等。包括环境检测、版本选择、下载、校验、解压、参数调优和端到端验证。现在让智能体完成此类制作,还是很简单的,这里不赘述,有需要帮助的建议自己动手跟AI对话,或baidu一下,都能解决。国内网络,从GitHub下载时很多时候会超时,可以让智能体切换到其它国内镜像。llama.cpp 0.4.0(build 10809)CUDA 13.3 版主程序和 Qwen3-8B模型下载、安装后,agent自动根据电脑配置进行了参数调优。
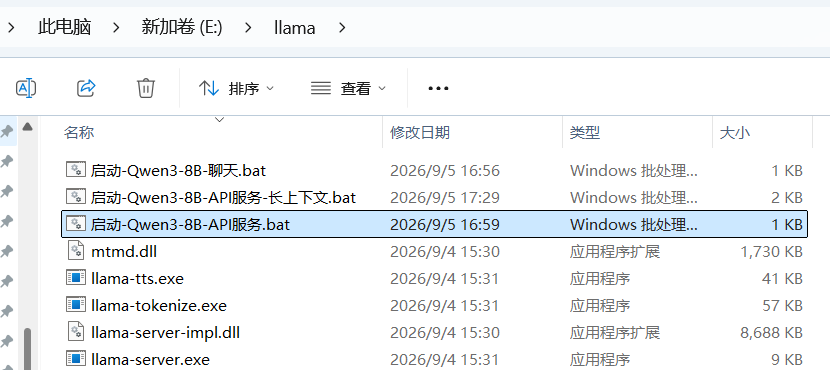
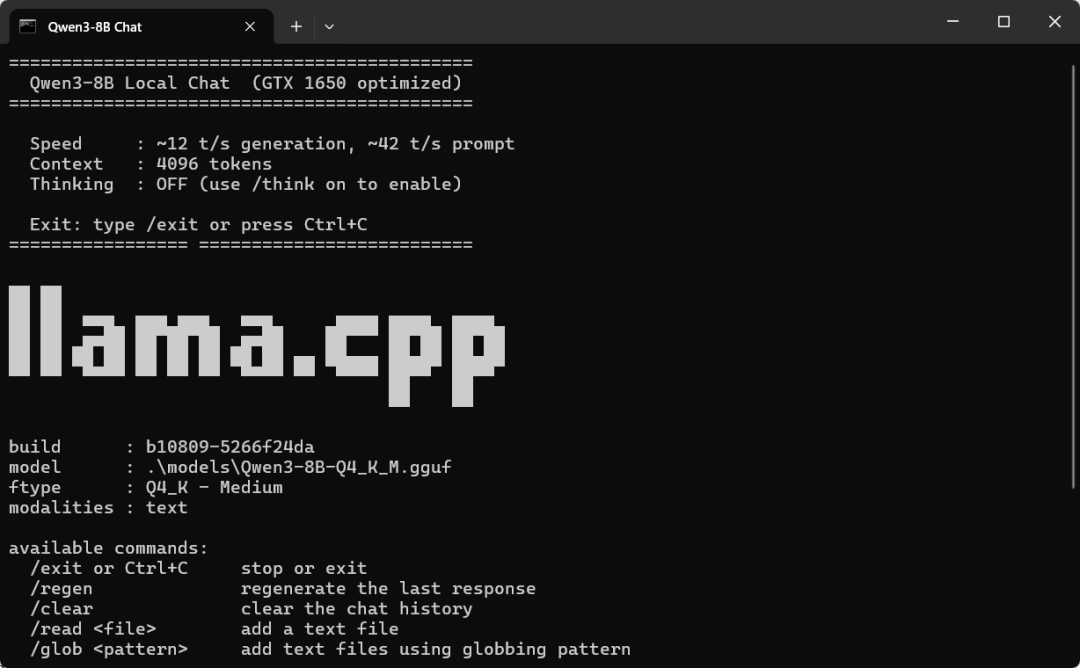
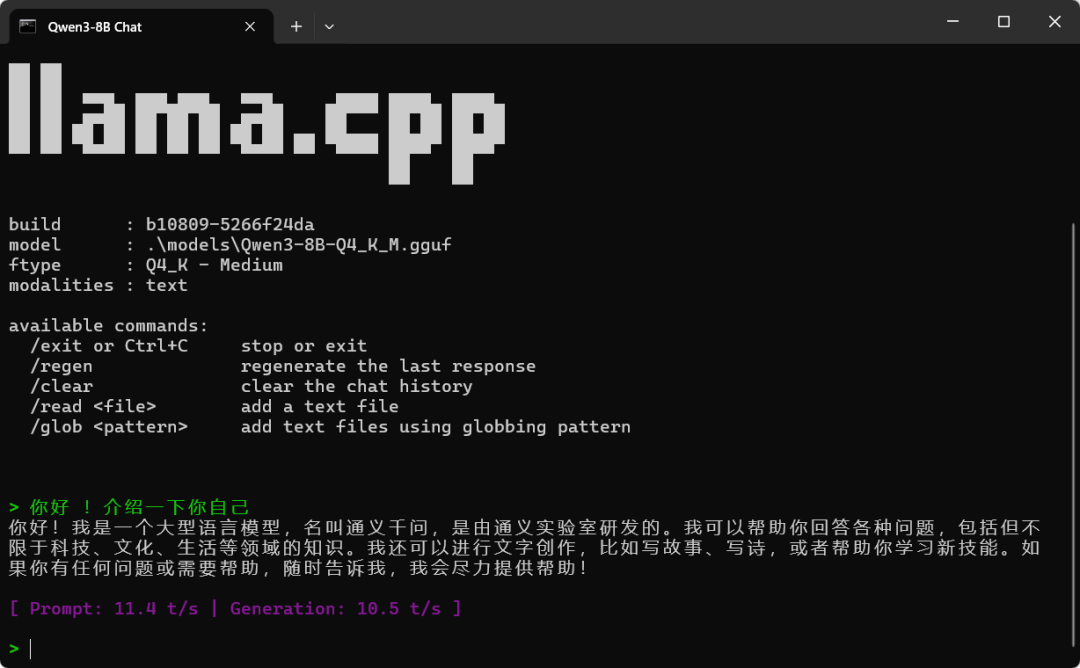
安装后的部分文件列表.bat文件是AI自动创建的,在命令行与AI对话,可双击聊天.bat。效果如下:
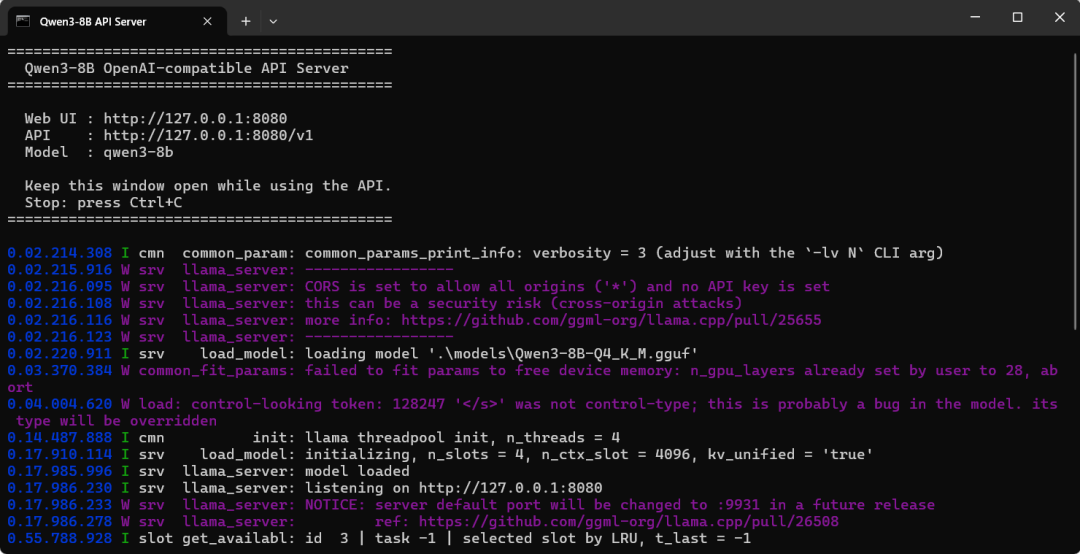
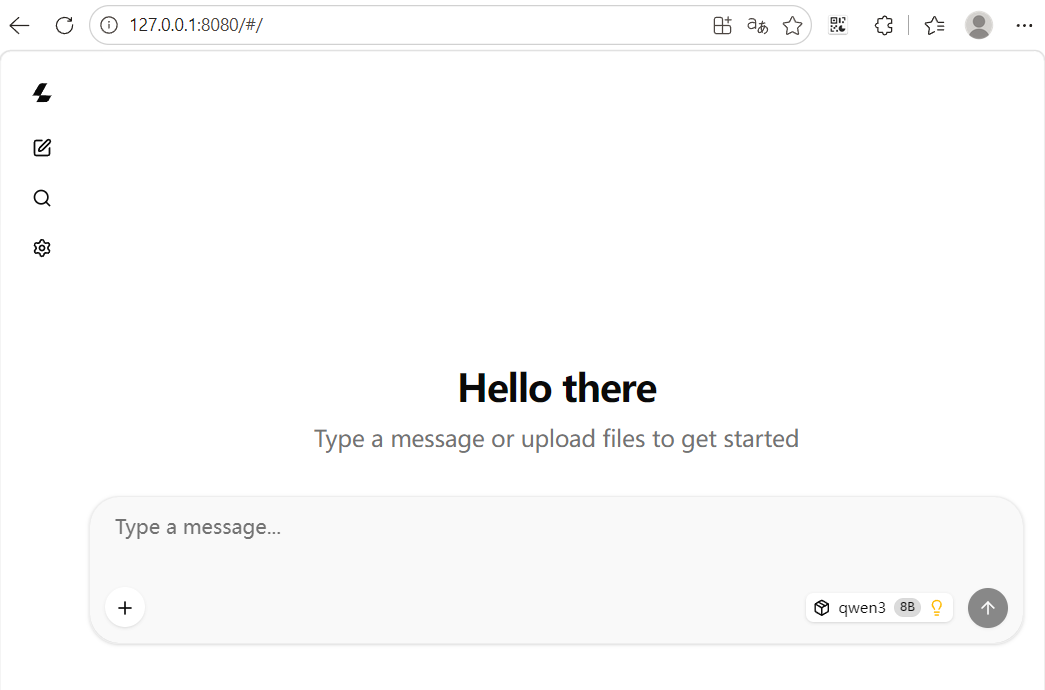
如想用于网页对话(类似于deekseep)或连接智能体,可双击服务.bat。运行后效果如下:
四、测试过程
(一)先进行基本的网页对话测试。
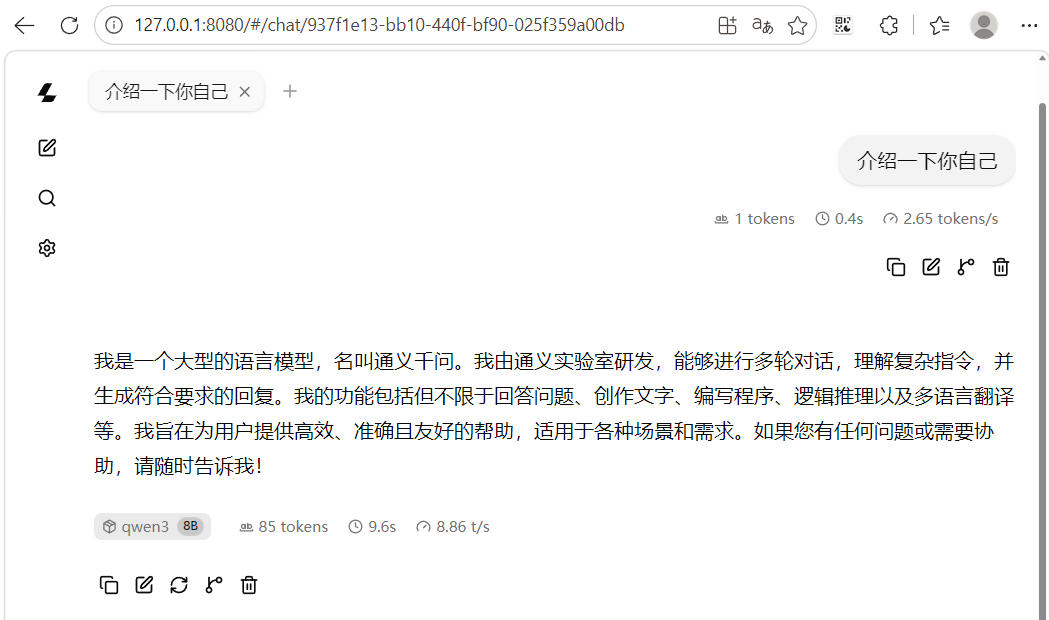
简单的对话回答中规中矩,下面增加点难度,看看几个月之前让众多模型都翻车的【洗车难题】回答的如何?
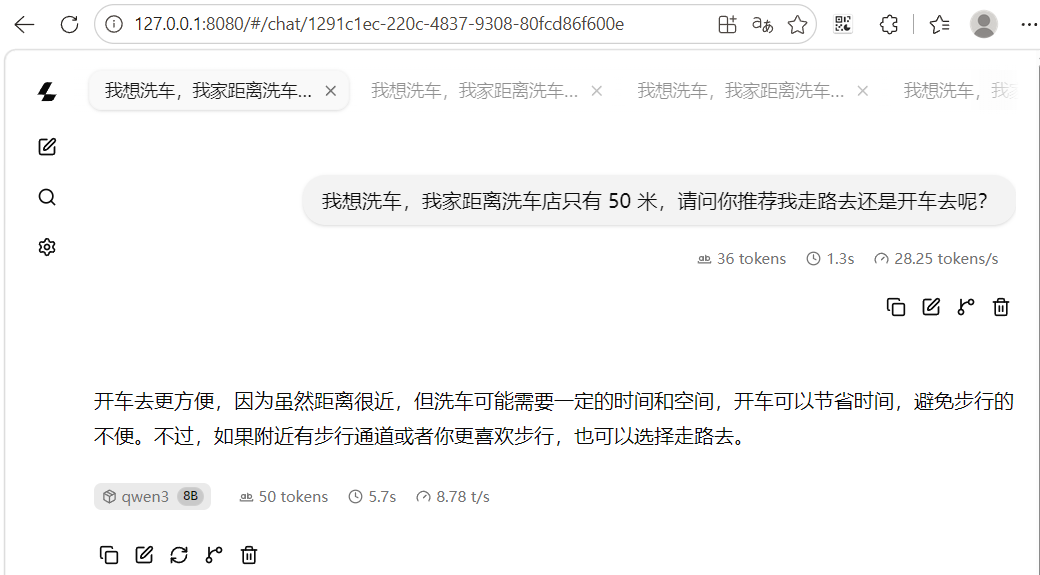
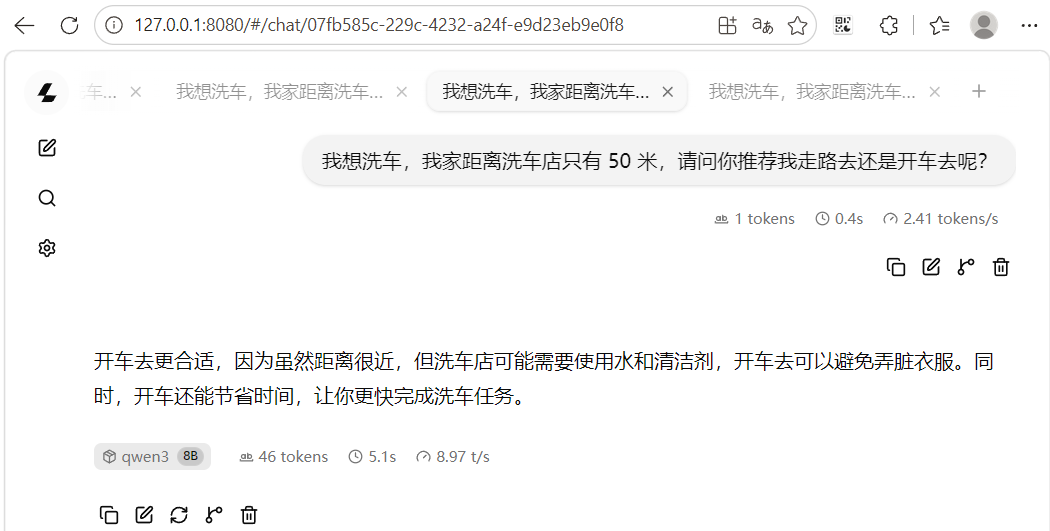
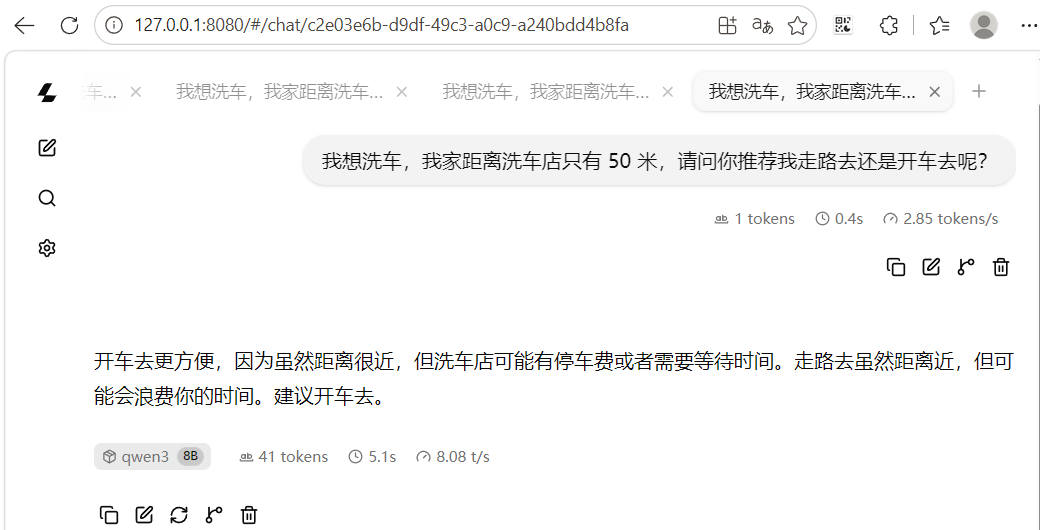
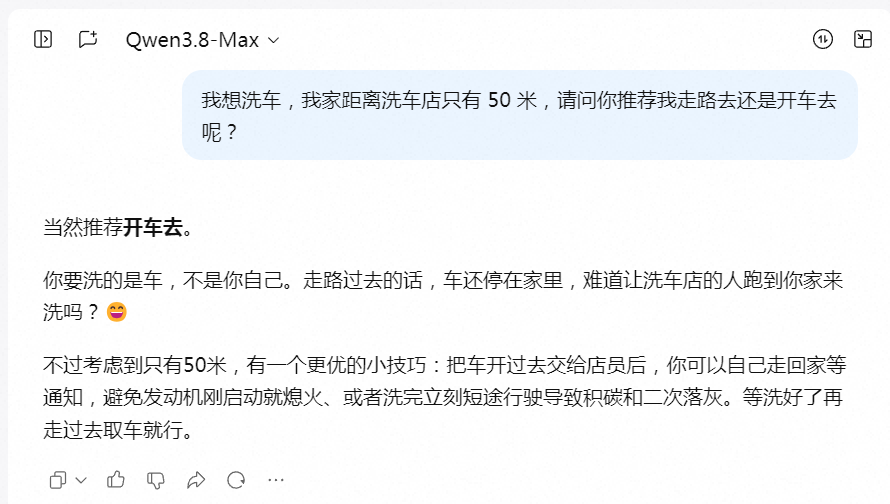
测试了几轮,虽然都让开车去,但都没有明确说“洗车一定要开车”的常识,甚至有些回答已经开始自相矛盾了,如“开车去更方便,因为虽然距离很近,但洗车店可能有停车费或者需要等待时间。”方便的原因,它认为是可能有停车费或需要等待时间。。。正常人难以理解的回答。让我们看看Qwen3.8-Max回答如何:
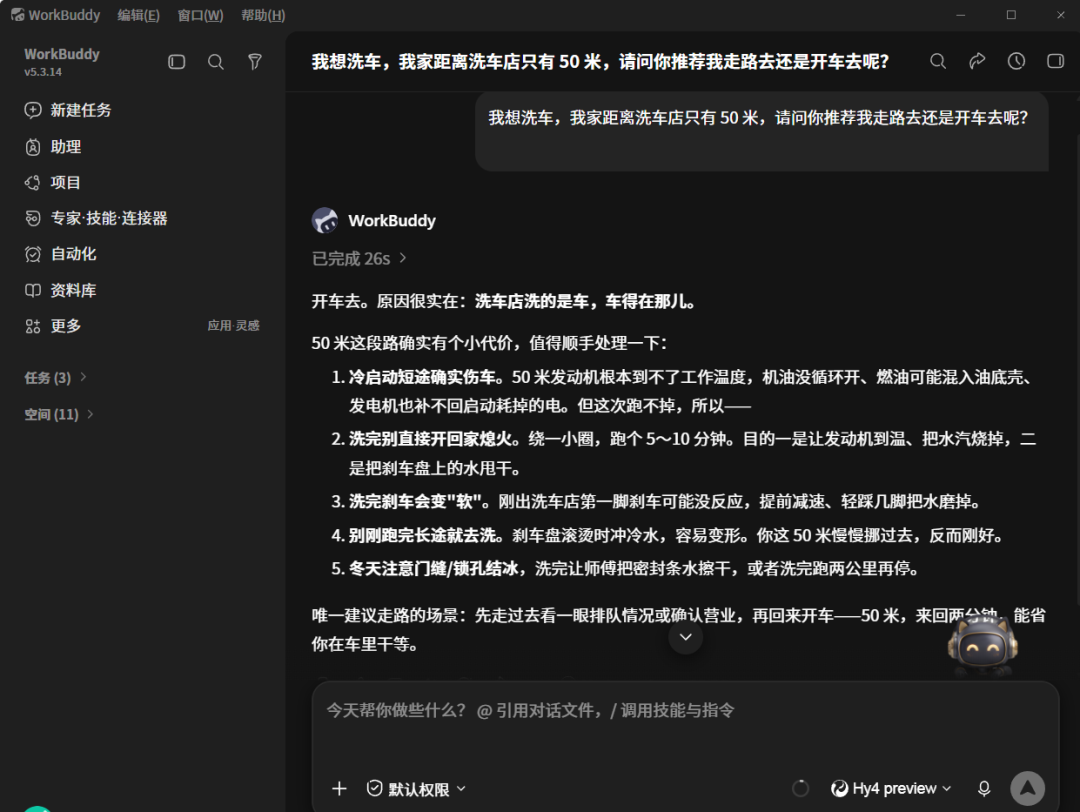
下面是Hy4的回答:
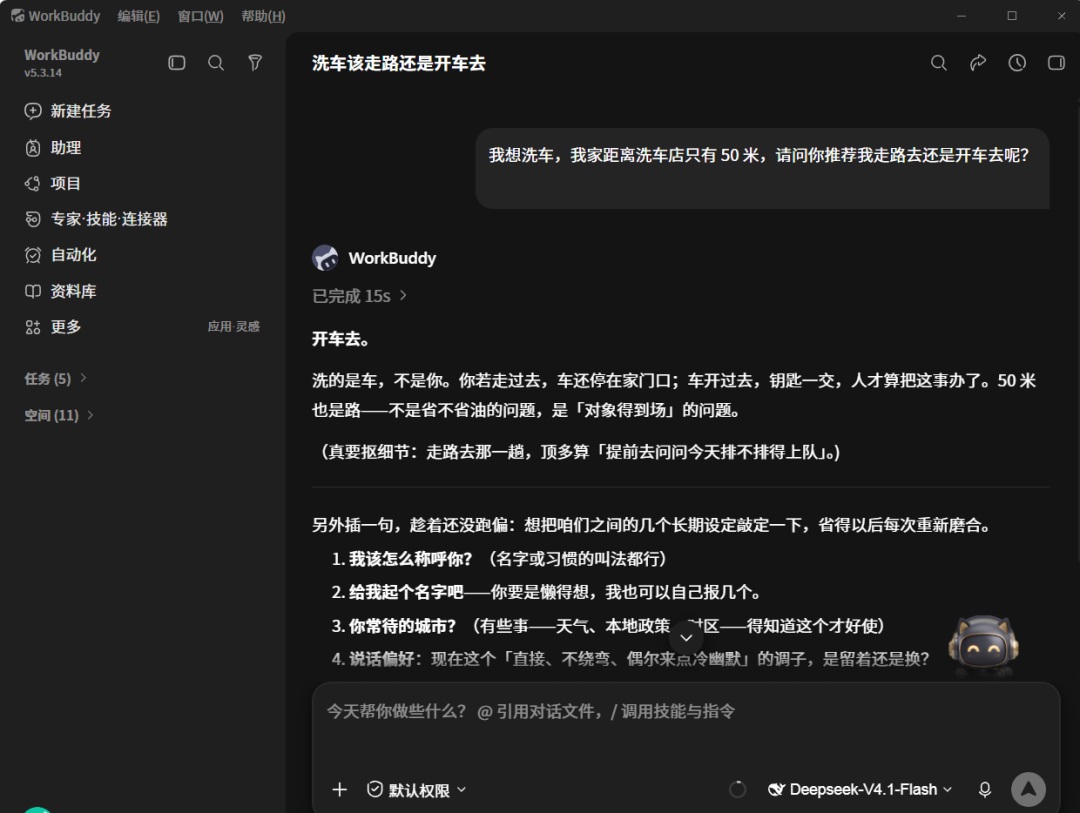
下面是Deepseek V4.1的回答:
下面是GLM-5.3的回答:
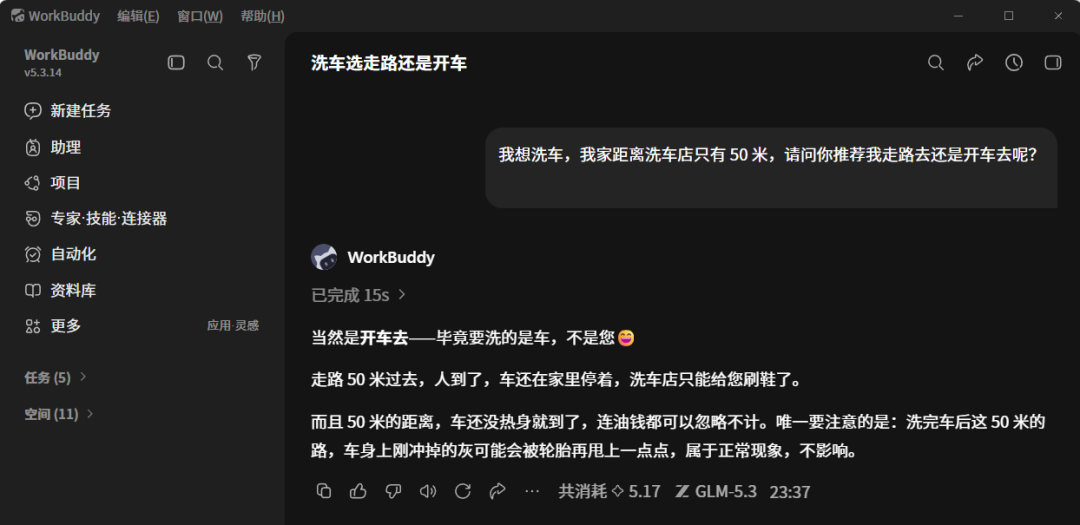
通过以上对比,可以看出,本地部署的小模型与云端旗舰模型有代差。我们在本地部署的Qwen-8B模型,和我们日常使用的云端旗舰模型相比,相当于幼儿园和大学生的智商(判断力)差距所以,如果不是内网环境不得不用的情况下,还是推荐使用云部署的大模型,现在还有很多是能免费用的。本地部署的小模型使用价值真的不大。如果非要本地部署,也得花点钱投资一下显卡或内存,部署个容量大些的模型才好。
(二)再来测试一下接入智能体后的应用情况
测试使用的是Workbuddy。配置如下:
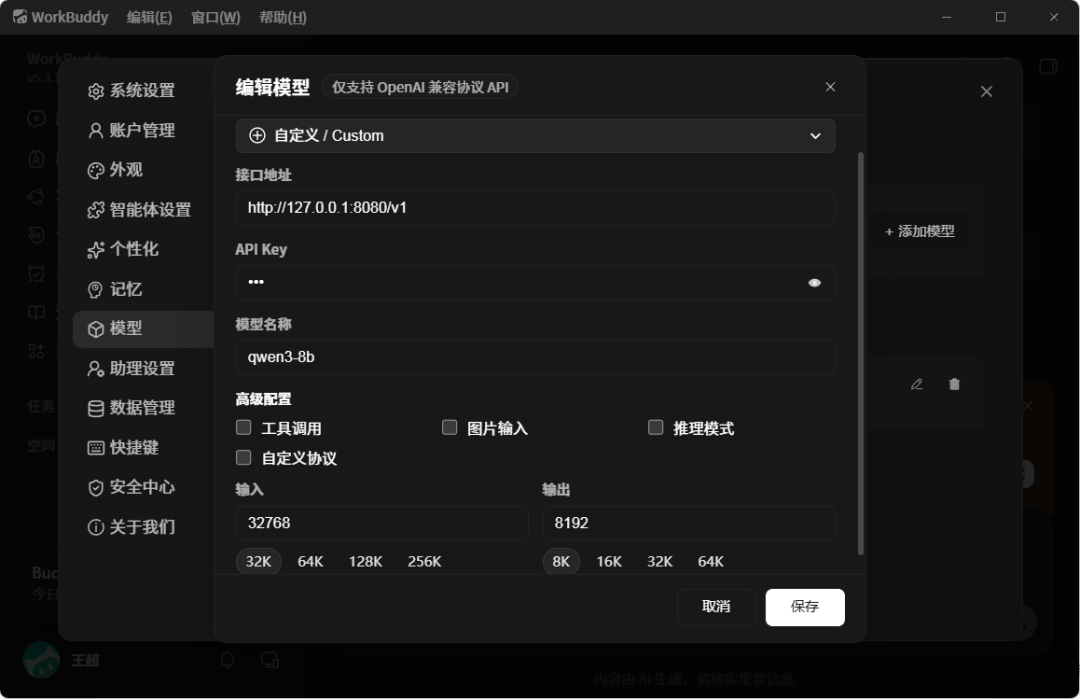
配置后,选择自己的模型,跟它对话,直接报错了。
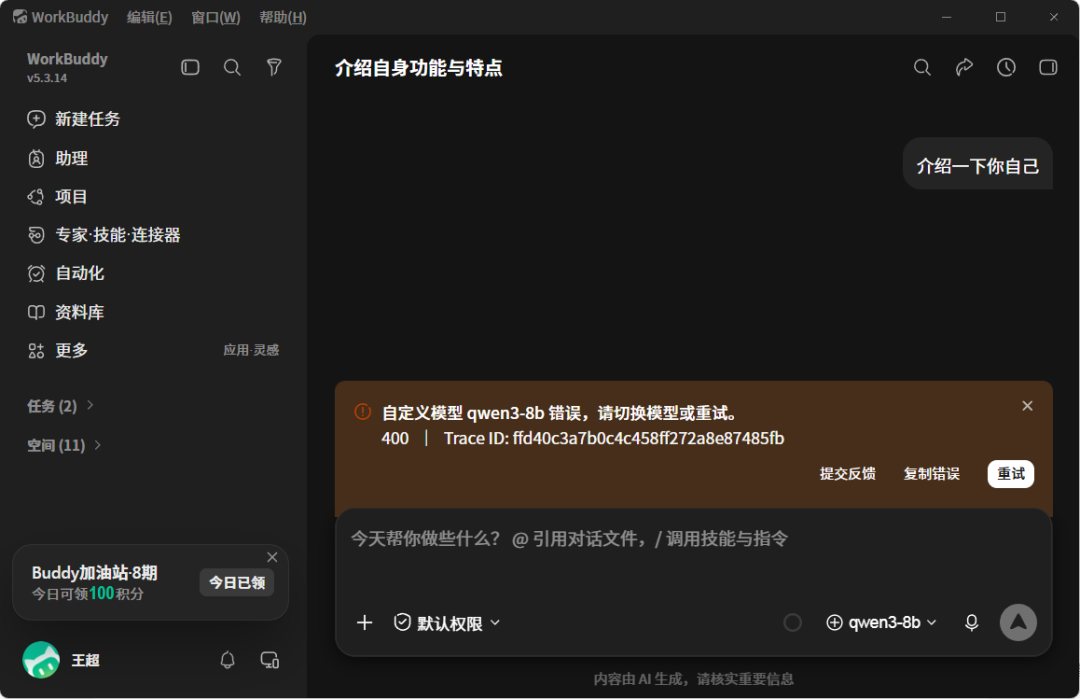
我们看一下后台日志:
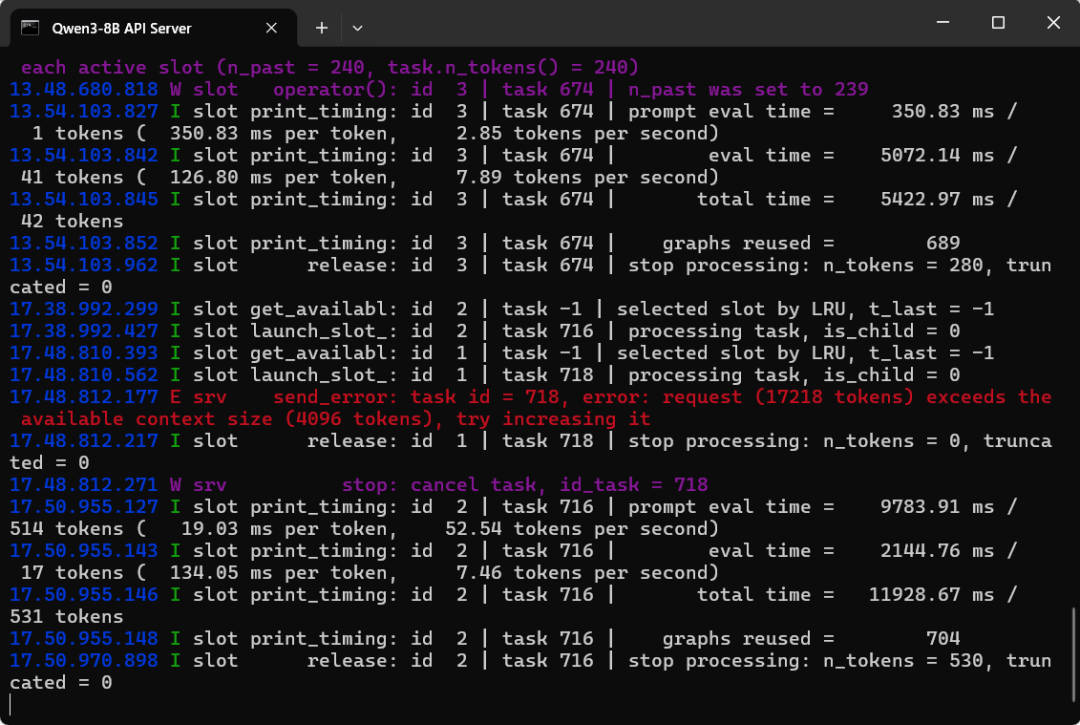
注意日志中红字部分,本次请求17218tokens,但模型只支持4096tokens。这还是把Workbuddy中的工具调用、图片输入等功能全关掉的情况。如果打开,最少要3万tokens。我测试过,类似这台配置的电脑,最多只能支持16000左右的tokens,所以在类似配置的电脑上部署的小模型,目前无法支撑起Workbuddy等智能体的正常运行。测试aardio autos也是同样的结果,aardio autos每次需要6万多的tokens,也不能正常使用。
五、结论
想自己本地部署AI的朋友们,可以自己动手尝试,想跑通并不难。在普通电脑上部署的小模型,网页对话、离线问答、写作翻译这类简单的短交互场景可以正常使用,但也要人工验证AI回答的是否准确,因为小模型判断力很低。对涉及敏感信息的场景,本地部署反而是更安全的选择——数据不出机器,不存在云端泄露的问题。用于 agent 工作负载不可行,原因有二。其一是上下文容量,agent 请求量普遍在 3 万至 6 万 tokens,既超出本机 4GB 显存能支撑的范围,也超出模型 32768 的原生上限,且即便强行调大参数,等待时间也长到无法接受。其二是模型判断力,8B 量级在多条件权衡类任务上表现不稳,难以支撑需要可靠推理的自动化流程。这两点都源于硬件规模,无法通过参数调整解决。4GB 显存决定了本地只能跑 8B 级别的 Dense 模型,而 MoE 架构虽然能绕开显存墙,文件体积却又超出 16GB 内存。若确实需要本地运行 agent,硬件上至少要有 24GB 显存,才能装下 30B-A3B 这类 MoE 模型并留出足够的 KV Cache 空间。#大模型 #本地部署 #实测记录